

Context Engineering
Context Engineering, pour donner à chaque agent IA le bon contexte
Beaucoup de projets d’IA fonctionnent lors des démos, puis se heurtent aux données et aux systèmes réels de l’entreprise en production. Le Context Engineering, ou ingénierie du contexte, consiste à fournir aux grands modèles de langage (LLM) et aux agents IA les bonnes informations au bon moment. Argonos retrouve et classe la connaissance pertinente, applique les droits d’accès et l’ancre dans ses sources afin que vos applications puissent fonctionner en production, sur votre propre infrastructure.
- 120+ possibilités d’intégration avec vos systèmes de référence
- 80 heures de développement évitées par application (rapport Forrester)
- 5X d’amélioration de la qualité des réponses entre programmes (Cummins)
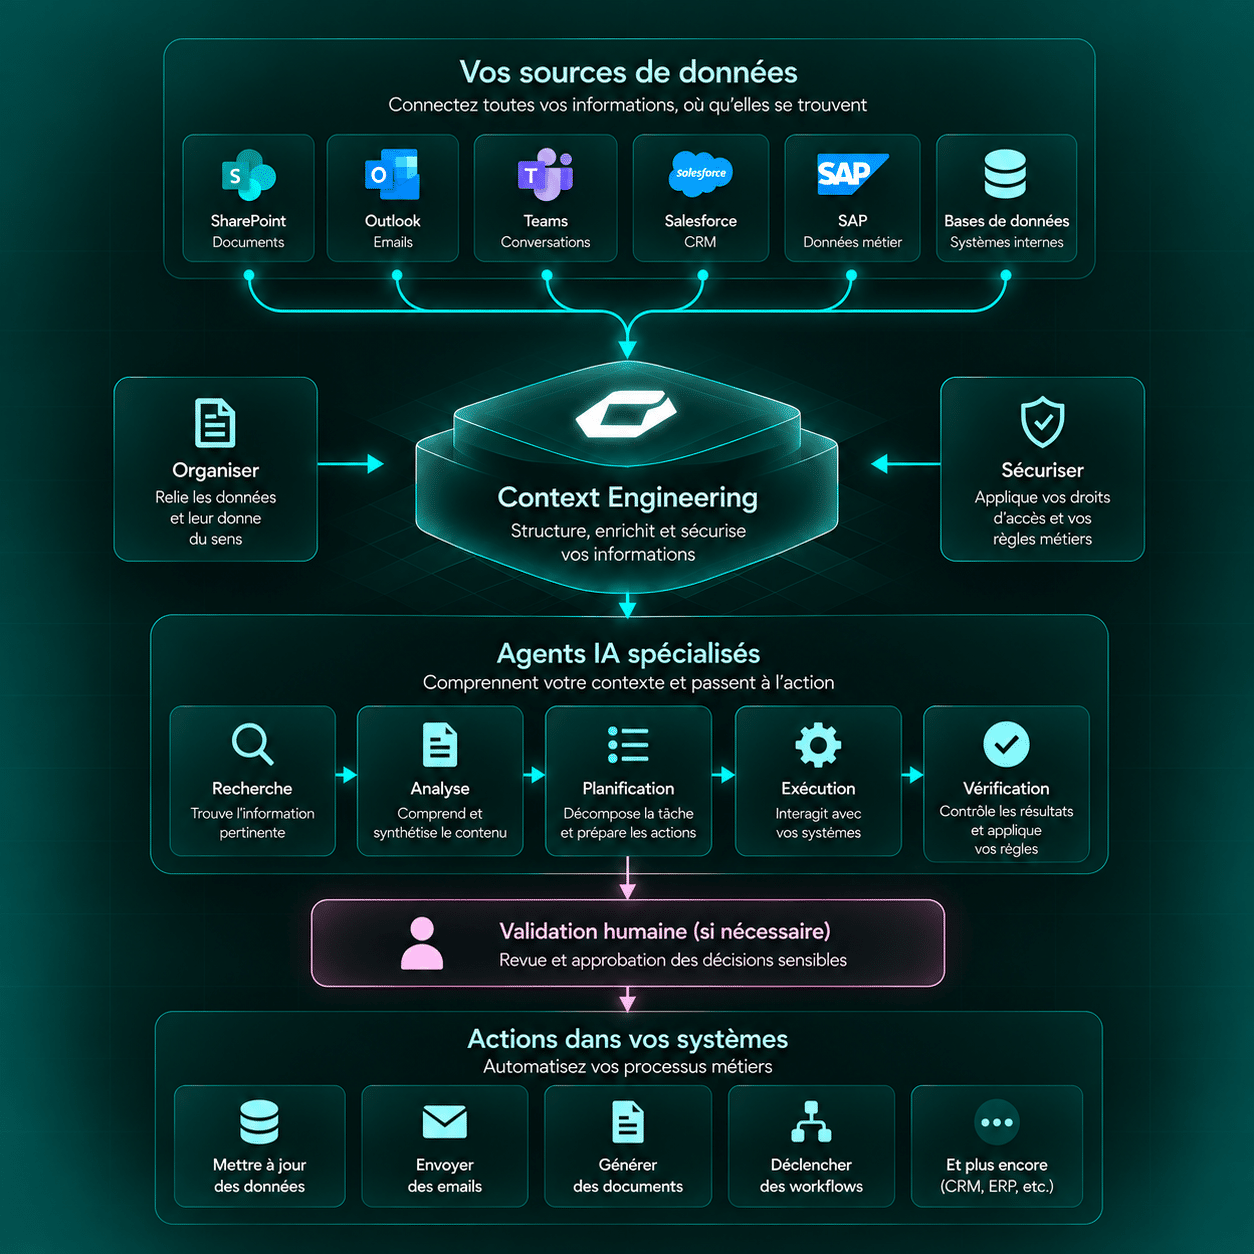
Un même socle de contexte, de la recherche à l’action
-
Retrouver
Argonos se connecte à vos systèmes de référence, mais aussi à vos documents et outils collaboratifs. Plans techniques, tickets et archives numérisées deviennent accessibles sans avoir à construire un pipeline spécifique au préalable.
-
Comprendre
Argonos retrouve dans les sources d’origine les passages utiles à vos questions, les reclasse et les fournit avec leurs références. Le modèle reçoit ainsi le contenu réellement pertinent, plutôt qu’un résultat simplement proche sur le plan sémantique.
-
Agir
Vos équipes développent leurs applications sur ce même socle, à travers des API familières aux développeurs. Une source connectée pour un premier usage peut ensuite être réutilisée par les autres applications.
-
Contrôler
Les droits d’accès proviennent de vos systèmes sources et chaque recherche est tracée. Une application ne peut restituer que les informations auxquelles l’utilisateur est autorisé à accéder.
UNE ÉVOLUTION DE FOND
Context Engineering et Prompt Engineering : quelle différence ?
Le Prompt Engineering optimise la formulation d’une instruction. Le Context Engineering organise tout ce que le modèle reçoit à chaque étape : instructions système, connaissance récupérée, mémoire et état de la tâche, ainsi que les sorties des outils. La génération augmentée par la récupération (RAG) en est donc une composante, mais pas la totalité. À l’échelle de l’entreprise, il ne s’agit plus de construire manuellement un pipeline pour chaque agent : il faut une couche de contexte capable de sélectionner, classer, filtrer et ancrer automatiquement la bonne connaissance.
Le bon contexte pour chaque usage
Argonos identifie et fournit les informations pertinentes pour chaque usage, tout en appliquant les droits d’accès. Vos équipes s’appuient sur un même socle pour leurs assistants, copilotes et agents IA, sans reconstruire un système de recherche pour chaque application.
Un assistant capable de répondre à toute l’entreprise
Un assistant accessible à toute l’entreprise reçoit des questions très diverses, portant sur des contenus qui n’ont pas nécessairement été préparés pour cet usage. Argonos détermine les informations pertinentes pour chaque demande et applique les droits d’accès au moment de la recherche.
- Retrouver l’information même lorsque l’utilisateur ne connaît pas le terme exact
- Respecter les droits d’accès entre départements dès la recherche
- Retrouver des contenus quelle que soit leur langue d’origine
- Ajouter de nouvelles sources sans reconstruire l’application
Quand la réponse est adressée à un client
Une réponse incorrecte adressée à un client n’a pas les mêmes conséquences qu’une erreur dans un outil interne. Argonos ancre chaque réponse dans des contenus approuvés et permet d’identifier les sources utilisées.
- Définir précisément les sources qu’une réponse peut utiliser
- Poser une question dans une langue et exploiter des contenus rédigés dans une autre
- Maintenir une recherche avancée à l’échelle d’un service client international
- Retrouver les informations utilisées pour chaque réponse contrôlée

La précision nécessaire aux métiers spécialisés
Un copilote destiné à des ingénieurs, des chercheurs ou des professionnels de santé doit comprendre le vocabulaire et les formats propres à leur domaine. Argonos recherche l’information dans les contenus réellement utilisés par ces métiers et s’appuie sur vos propres ontologies.
- Rendre exploitables les plans, tableaux et documents numérisés
- Comprendre les différentes terminologies utilisées pour désigner un même élément
- Retrouver le passage pertinent plutôt que restituer un document entier
- Identifier la version du document qui fait référence

Quand l’information retrouvée déclenche une action
Lorsqu’un agent ou un outil utilise une information pour poursuivre une tâche, la qualité du contexte devient déterminante. Argonos fournit aux agents et aux workflows la même couche de contexte gouvernée que celle utilisée par vos équipes.
- Définir les sources auxquelles chaque application peut accéder
- Fournir à chaque étape uniquement le contexte dont elle a besoin
- Identifier le bon enregistrement lorsque plusieurs résultats sont proches
- Utiliser une même couche de recherche pour plusieurs agents
Ce qu’en disent nos clients

Nos ingénieurs peuvent poser une question complexe, composée de plusieurs éléments, et obtenir une réponse concise accompagnée des éléments qui la justifient. Cela change considérablement notre manière de travailler sur la conception, la garantie et l’analyse des défaillances.
Context Engineering
Comprendre le Context Engineering pour l’IA d’entreprise
Le Context Engineering est essentiel pour les applications d’intelligence artificielle en entreprise. Une démonstration peut fonctionner parfaitement sur quelques documents sélectionnés et produire des résultats beaucoup moins fiables lorsqu’elle est confrontée aux systèmes, aux droits d’accès et aux données réelles de l’organisation.
Le problème ne vient pas nécessairement du grand modèle de langage (LLM) ni du prompt. Il vient souvent du contexte qui lui est fourni : l’information pertinente n’a pas été retrouvée, une version obsolète a été privilégiée ou le modèle a reçu trop de contenu peu utile. Le Context Engineering, ou ingénierie du contexte, consiste précisément à organiser ce que le modèle peut voir, à quel moment et dans quelles conditions.
Du Prompt Engineering au Context Engineering
Le Prompt Engineering optimise la formulation de l’instruction donnée au modèle. Le Context Engineering porte sur un périmètre plus large : tout l’environnement informationnel mis à disposition du modèle au moment où il travaille.
Un grand modèle de langage génère sa réponse à partir des éléments présents dans sa fenêtre de contexte. Cette fenêtre joue le rôle d’une mémoire de travail : elle contient les instructions, les informations retrouvées dans les sources de l’entreprise, l’état de la tâche et les résultats produits par les outils utilisés par l’application ou l’agent.
Le Context Engineering consiste à sélectionner ce qui entre dans cette fenêtre, à éliminer le bruit, à hiérarchiser les informations utiles et à recommencer lorsque le contexte évolue au fil d’une tâche. À l’échelle d’une entreprise, cette opération ne peut pas reposer sur un assemblage manuel différent pour chaque application.
Les quatre composantes du Context Engineering
Le Context Engineering combine plusieurs mécanismes qui doivent fonctionner ensemble. Les instructions système définissent le cadre dans lequel le modèle intervient. La récupération de connaissance permet d’aller chercher les informations pertinentes dans les sources de l’entreprise. La mémoire et l’état conservent ce qui a déjà été établi au cours de la tâche. Enfin, les outils permettent à l’application ou à l’agent d’interagir avec d’autres systèmes et d’utiliser leurs résultats comme nouveau contexte.
À cela s’ajoutent les mécanismes de sélection, de compression, de reclassement et d’isolation du contexte. L’objectif n’est pas de remplir au maximum la fenêtre de contexte, mais de fournir au modèle les informations réellement utiles à chaque étape.
Le RAG est une composante du Context Engineering, pas sa totalité
La génération augmentée par la récupération (RAG) répond à une question essentielle : quelles informations faut-il retrouver et fournir au modèle pour répondre à une demande donnée ? Elle constitue donc une brique importante du Context Engineering, mais elle n’en couvre qu’une partie.
Le Context Engineering doit également déterminer quelles instructions s’appliquent, ce que l’agent sait déjà des étapes précédentes, quels résultats viennent d’être produits par ses outils et quelles informations doivent être conservées ou écartées lorsque tout ne peut pas tenir dans la fenêtre de contexte.
Une application peut disposer d’un bon système de RAG et produire malgré tout une mauvaise réponse. Une ancienne version d’un document peut avoir été privilégiée. Plusieurs résultats proches peuvent avoir été mal classés. Des informations appartenant au contexte d’une autre tâche peuvent avoir été introduites. Dans ces situations, le problème ne vient pas nécessairement de la récupération elle-même, mais de la manière dont l’ensemble du contexte a été constitué.
La connaissance de l’entreprise ne se trouve pas dans un seul référentiel
À l’échelle de l’entreprise, la difficulté commence souvent avant même le RAG. Les informations utiles ne sont pas regroupées dans une base vectorielle prête à être interrogée. Elles se trouvent dans un PLM, un ERP, un système qualité, des bases métier, des outils collaboratifs ou des espaces documentaires contenant parfois plusieurs années d’archives.
Accéder à cette connaissance suppose de connecter ces systèmes, d’indexer des données structurées et non structurées, de prendre en charge différents formats et de rapprocher des informations qui désignent une même pièce, un même client ou un même dossier avec des terminologies différentes.
La recherche vectorielle et les plongements vectoriels permettent de retrouver des contenus proches sur le plan sémantique. Les mécanismes de reclassement améliorent ensuite leur pertinence. Mais ces technologies ne suffisent pas à déterminer quelles sources font référence, quelle version doit être utilisée ni quels utilisateurs sont autorisés à consulter l’information.
C’est cette infrastructure qui sépare un prototype construit sur quelques documents d’une capacité de Context Engineering exploitable à l’échelle de l’entreprise.
Industrialiser le Context Engineering à l’échelle de l’entreprise
Construire un pipeline spécifique pour chaque assistant ou chaque agent multiplie les connexions aux mêmes systèmes, les règles de sécurité et les mécanismes de recherche à maintenir. Une couche de contexte commune permet au contraire de mutualiser ce travail.
Les connecteurs, l’index, les ontologies, les mécanismes de classement et les règles d’accès mis en place pour un assistant interne peuvent ensuite être réutilisés par un copilote métier, une application destinée aux clients ou un agent chargé d’un workflow.
Sinequa, le Knowledge Engine d’Argonos, fournit les capacités de recherche, de récupération avancée et de connexion aux sources qui permettent d’exploiter la connaissance de l’entreprise comme contexte pour les applications IA. Cette approche transforme le Context Engineering en capacité de plateforme plutôt qu’en succession de pipelines développés application par application.
Enterprise Search et AI Data Interrogation utilisent cette même connaissance pour permettre aux collaborateurs de trouver ou d’interroger l’information. Le Context Engineering répond à un besoin différent : fournir aux grands modèles de langage et aux agents IA le contexte dont ils ont besoin pour travailler. Les agents consomment ensuite ce contexte pour préparer ou exécuter des actions sous le contrôle des équipes.
Droits d’accès, traçabilité et empoisonnement du contexte
Une couche de contexte d’entreprise doit appliquer les droits d’accès avant que l’information ne soit transmise au modèle. Pour chaque demande, le contexte disponible doit correspondre aux droits de la personne ou de l’application concernée.
Filtrer uniquement la réponse finale serait insuffisant : le modèle aurait déjà reçu des informations auxquelles l’utilisateur n’était pas autorisé à accéder. Le filtrage doit donc intervenir au moment de la récupération, en s’appuyant sur les habilitations définies dans les systèmes sources.
La qualité des informations retrouvées est tout aussi importante. Une procédure obsolète, un plan remplacé par une nouvelle version ou un document provenant d’une source non approuvée peuvent introduire un contexte erroné. C’est l’un des risques d’empoisonnement du contexte : le modèle travaille à partir d’une information inadéquate sans nécessairement être capable de l’identifier comme telle.
La maîtrise des sources, des versions et de l’attribution permet de limiter ce risque. La traçabilité permet ensuite de retrouver les informations utilisées pour une réponse et d’identifier l’origine d’une erreur lorsqu’elle survient.
La souveraineté concerne aussi le contexte fourni aux modèles
Le contexte transmis à un modèle peut contenir certaines des informations les plus sensibles de l’entreprise. La souveraineté des données ne concerne donc pas uniquement le choix du modèle. Elle porte également sur l’endroit où le contexte est constitué, traité et transmis.
Selon les exigences de l’organisation, ces traitements peuvent être réalisés dans un environnement maîtrisé ou on-premise. L’entreprise conserve ainsi le contrôle des données envoyées aux modèles et peut choisir les modèles adaptés à chaque usage.
Pour les services financiers, les sciences de la vie, l’aéronautique et la défense, l’industrie ou le secteur public, cette maîtrise conditionne directement la possibilité de déployer l’intelligence artificielle sur des données sensibles ou réglementées.
Du pilote à une capacité réutilisable
Traiter le Context Engineering comme une capacité de plateforme permet de réutiliser le travail réalisé pour une première application. Une source connectée et gouvernée pour un assistant interne peut ensuite alimenter un copilote métier ou un agent sans reconstruire toute la chaîne d’accès à la connaissance.
Chez Cummins, la source de cette page associe cette même infrastructure à une amélioration par cinq de la qualité des réponses entre différents programmes. Le chiffre correspond à ce cas d’usage et ne constitue pas une promesse de performance identique pour chaque déploiement.
Pour les responsables de plateformes IA, la question n’est donc plus seulement de savoir quel modèle utiliser. Il faut aussi déterminer quelles informations ce modèle peut consulter, d’où elles proviennent, quels droits s’appliquent, quelle version fait référence et comment retrouver les sources utilisées lorsqu’une réponse doit être vérifiée.
C’est tout l’enjeu du Context Engineering à l’échelle de l’entreprise : fournir automatiquement aux LLM et aux agents IA la connaissance pertinente, dans le bon contexte et sous les bonnes règles de gouvernance.